DeepMind的计算机科学家Sebastian Ruder给出了21世纪以来,从神经网络技术的角度分析,自然语言处理的里程碑式进展,如下表所示:
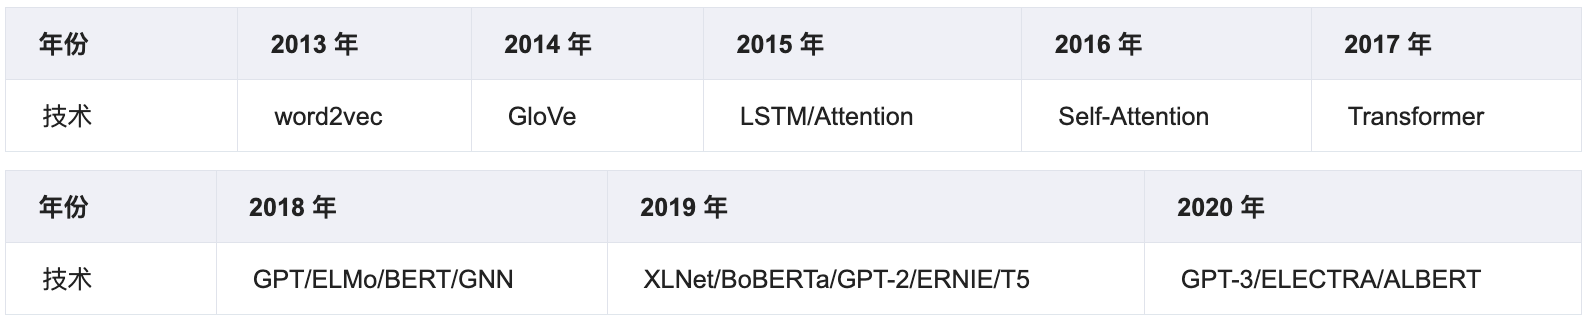
自然语言处理的发展可以分为两个阶段
不懂语法怎么理解语言?
20世界50年代到70年代,人们对自然语言处理的认知都局限在人类学习语言的方式上。当时学界普遍认为,要让计算机处理自然语言必须先让其理解语言,因此分析语句和获取语义成为首要任务,而这主要由语言学家人工总结文法规则来实现。
特别是 20 世纪 60 年代,基于乔姆斯基形式语言(Chomsky Formal languages)的编译器取得了很大进展,更加鼓舞了研究者通过概括语法规则来处理自然语言的信心。
但是与规范严谨的程序语言不同,自然语言复杂又灵活,是一种上下文有关法(Context-Sensitive Grammars, CSGs),因此仅靠人工编写文法规则根本无法覆盖,而且随着编写的规则数量越来越多、形式越来越复杂,规则与规则之间还可能会存在矛盾。因此这一阶段自然语言处理的研究可以说进入了误区。
只要看得足够多,就能处理语言
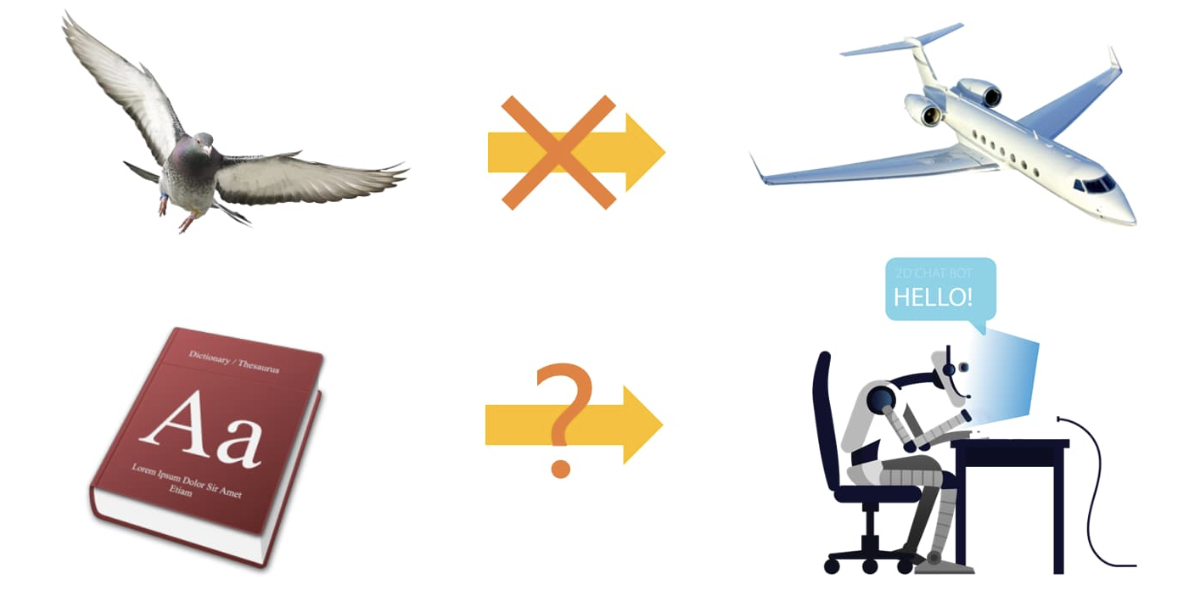
正如人类是通过空气动力学而不是简单模仿鸟类造出了飞机,计算机处理自然语言也未必需要理解语言。
- 20 世纪 70 年代,随着统计语言学的提出,基于数学模型和统计方法的自然语言处理方法开始兴起。当时的代表性方法是“通信系统加隐马尔可夫模型”,其输入和输出都是一维且保持原有次序的符号序列,可以处理语音识别、词性分析等任务,但是这种方法在面对输出为二维树形结构的句法分析以及符号次序有很大变化的机器翻译等任务时就束手无策了。
- 20 世纪 80 年代以来,随着硬件计算能力的提高以及海量互联网数据的出现,越来越多的统计机器学习方法被应用到自然语言处理领域,例如一些研究者引入基于有向图的统计模型来处理复杂的句法分析任务。2005 年 Google 公司基于统计方法的翻译系统更是全面超过了基于规则的 SysTran 系统。
- 2006年,随着Hinton证明深度信念网络(Deep Believe Networks, DBN)可以通过逐层预训练策略有效地进行训练,基于神经网络和反向传播算法(Back Propagation)的深度学习方法开始兴起。许多之前由于缺乏数据、计算能力以及有效优化方法而被忽视的神经网络模型得到了复兴。例如 1997 年就已提出的长短时记忆网络(Long Short Term Memory,LSTM)模型在重新被启用后在许多任务上大放异彩。 即使在 Transformer 模型几乎“一统江湖”的今天,LSTM 模型依然占有一席之地。2024 年 5 月 8 日,LSTM 提出者和奠基者 Sepp Hochreiter 公布了 LSTM 模型的改良版本——xLSTM,在性能和扩展方面都得到了显著提升。论文的所属机构中还出现了一家叫做 NXAI 的公司,Sepp Hochreiter 表示:“借助 xLSTM,我们缩小了与现有最先进大语言模型的差距。借助 NXAI,我们已开始构建欧洲自己的大语言模型。”
- 随着越来越多研究者将注意力转向深度学习方法,诸如卷积神经网络(Convolutional Neural Networks,CNN)等模型被广泛地应用到各种自然语言处理任务中。Google 公司提出了 Attention 注意力模型,论文中提出的 Transformer 结构更是引领了后续神经网络语言模型的发展。得益于抛弃了让计算机简单模仿人类的思路,这一阶段自然语言处理研究出现了蓬勃发展。今天可以说已经没有人再会质疑统计方法在自然语言处理上的可行性。
语言模型发展史
统计语言模型
统计语言模型的基本思想就是计算条件概率
给定一句由n个词组成的句子
其中对于
有时会假设满足马尔可夫链进行改写。
考虑几个词的相关性,就成为几元语言模型。考虑到数据稀疏问题,采用平滑策略
NNLM
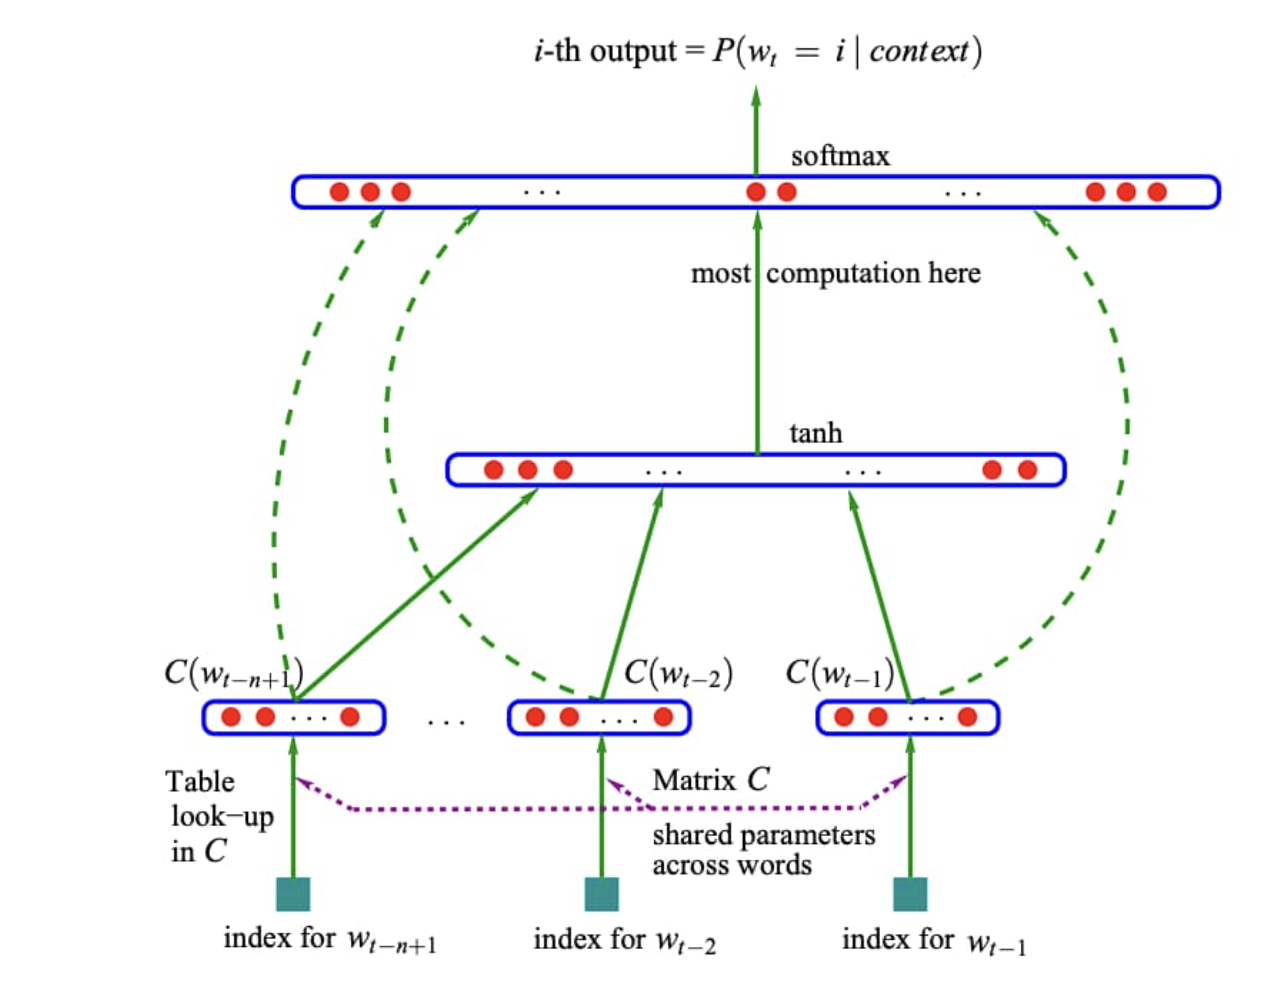
在2003年有Bengio提出了神经网络语言模型(NNLM),可惜生不逢时,当时并不被人们看好。它通过输入词语前面的N-1个词来预测当前词,模型结构如下:
Word2Vec
词向量:简单地使用Onehot编码无法解决词与词之间的相似问题,因此引入 Word Embedding,通过计算余弦相似度来展现相似性
Word2Vec模型: 两种训练方法:
- CBOW, 核心思想是用一个词的上文和下文去预测这个词
- Skip-gram, 和CBOW刚好相反,输入某个单词,预测上下文
ELMo
在Word Wmbedding 中,词的表示方法本质上是静态的,每个词都有唯一确定的词向量,不能根据句子的不同而改变。针对该问题,ELMo提供了一个解决方案。根据上下文单词的语义对Word Embedding 进行动态调整。
预训练 采用双层双向LSTM,如果训练好以后不仅仅可以学会单词的Word Embedding, 还可以得到一个双层的LSTM网络结构
ELMo的Featured-based Pre-training
- 先将句子X作为预训练好的ELMo网络的输入,这样句子X中每个单词在ELMo网络中都可以获得对应的三个Embedding;
- 之后给予这三个Embedding中的每一个Embedding一个可学习的权重,整合成一个,作为下游任务中的新单词输入
- 对于的下游任务QA中的回答句子Y来说也是如此
由于ELMo给下游提供的是每个单词的特征形式,故而称为“Feature-based Pre-training” 这样有效的原因也是因为,通过引入上下文,强化某种语义,弱化其他语义,从而解决了很多同义词的问题。
Attention
从人类视觉注意力中可以看出,Attention的本质思想就是从大量信息中选择地筛选出少量重要信息并聚焦在这些重要信息上。并且Attention机制能够更好地解决序列长距离依赖问题,并且具有并行计算的能力。
Self Attention
- 获取Q、K、V:通过词向量与
进行点乘得到 - 计算
- Scale:对方差进行归一化,除以
- Softmax
- 将得到的注意力矩阵与 V进行相乘 Self Attention名字的来源即由于Attention的计算来源于Source(源句)和Source本身 相比于RNN和LSTM,一方面Self Attention更容易捕捉远距离依赖特征,且每个单词都可以单独进行注意力计算,从而对计算的并行性也有帮助。而RNN这种需要依次计算,无法做到并行计算。
- 获取Q、K、V:通过词向量与
Masked Self Attention 就是在Scale和Softmax步骤之间加了一个mask,掩盖掉每个词对未来词语的attention
Multi-head Self Attention 一般来说注意力矩阵很稀疏,可以被低秩分解;另一方面多头注意力,可以关注不同维度语义空间的信息
Position Embedding
由于Attention最终计算结果会被加权求和,从而事实上丢掉了序列的顺序信息。从而Transformer的提出者提出了Position Embedding,也就是:
位置编码公式如下:
故某个单词位置信息就是其他单词位置信息的线性组合,从而蕴含了相对位置信息
Transformer
整体框架:
其中Encoder-Decoder attention部分,使用encoder的输出计算K,V,用decoder做完 Masked Multi-Head Attention后的输出计算Q,再做cross attention
Feed Forward层:包含两个线性变换和一个ReLU激活函数
最终的output-head,使用embedding的参数
BERT
公认的里程碑
- 从大量无标记数据集中训练得到深度模型,显著提高各项任务的准确率
- 近年来优秀预训练语言模型的集大成者:参考了 ELMO 模型的双向编码思想、借鉴了 GPT 用 Transformer 作为特征提取器的思路、采用了 word2vec 所使用的 CBOW 方法
BERT和GPT和ELMO之间的区别
GPT:GPT 使用 Transformer Decoder 作为特征提取器、具有良好的文本生成能力,然而当前词的语义只能由其前序词决定,并且在语义理解上不足
BERT:使用了 Transformer Encoder 作为特征提取器,并使用了与其配套的掩码训练方法。虽然使用双向编码让 BERT 不再具有文本生成能力,但是 BERT 的语义信息提取能力更强
ELMO:使用自左向右编码和自右向左编码的两个 LSTM 网络,分别以
和
为目标函数独立训练,将训练得到的特征向量以拼接的形式实现双向编码,本质上还是单向编码,只不过是两个方向上的单向编码的拼接而成的双向编码。
BERT训练方式
- 语言掩码模型(MLM)
- 下句预测(NSP)